Scanpy
Python驱动单细胞RNA测序数据分析,快速处理百万级细胞数据,实现高级可视化。
30 秒判断
先看这四点,再决定要不要继续读完整评测。
如果你的研究涉及单细胞RNA测序,且数据量较大(例如百万级细胞),Scanpy是必学工具,能大幅提升分析效率和结果可视化质量。
需要处理大规模单细胞RNA测序数据,并希望通过Python进行高度定制化、高性能分析的生物信息学研究员、计算生物学家及医学科研人员。
完全没有编程经验,偏好图形用户界面(GUI)操作,或仅需处理极小规模单细胞数据进行基础统计分析的用户。
安装Scanpy:确保已安装Python和conda环境。
需要处理大规模单细胞RNA测序数据,并希望通过Python进行高度定制化、高性能分析的生物信息学研究员、计算生物学家及医学科研人员。
完全没有编程经验,偏好图形用户界面(GUI)操作,或仅需处理极小规模单细胞数据进行基础统计分析的用户。
Seurat / Seurat (R语言,功能类似,更注重R生态系统和交互式可视化) / Cell Ranger (上游数据处理,用于原始测序数据比对和计数矩阵生成)
视频演示
1st scanpy session - overview and experimental considerations · en
适合谁用
致力于单细胞RNA测序数据分析,需要高效处理大规模数据集并进行复杂生物学解释的生物信息学研究员、计算生物学家及医学科研人员。
用它完成一次可复现数据分析
把分析过程留下来,而不只是导出一张漂亮图。
输入材料
一份清洗后的数据表和明确的统计问题
应该得到
分析代码/流程、结果表、图表和解释边界
- 1先写下变量定义、样本筛选和主要结局。
- 2选择合适的统计方法,并记录为什么这么选。
- 3生成结果表和图表,同时保存参数、版本和代码。
- 4把统计显著性、效应量和临床意义分开解释。
人工核验点
- 变量和样本数是否一致
- 方法是否符合数据类型
- 图表是否能被他人复现
更适合
需要处理大规模单细胞RNA测序数据,并希望通过Python进行高度定制化、高性能分析的生物信息学研究员、计算生物学家及医学科研人员。
不太适合
完全没有编程经验,偏好图形用户界面(GUI)操作,或仅需处理极小规模单细胞数据进行基础统计分析的用户。
数据与隐私
Scanpy是一个本地运行的Python库,不涉及数据上传至外部服务器。因此,数据隐私完全取决于用户本地计算环境的安全措施和数据管理规范。
医学科研场景
- <strong>肿瘤异质性分析</strong>:通过对肿瘤微环境中的免疫细胞、基质细胞和肿瘤细胞进行单细胞分型,揭示肿瘤内部的细胞多样性及其在疾病进展和治疗抵抗中的作用。
- <strong>自身免疫疾病机制探索</strong>:识别类风湿关节炎、系统性红斑狼疮等自身免疫疾病患者体内异常活化的免疫细胞亚群,并分析其关键致病基因和信号通路,为靶向治疗提供依据。
- <strong>心血管疾病细胞图谱构建</strong>:绘制心脏组织在健康与疾病状态下的细胞图谱,识别心肌梗死后纤维化、心力衰竭等病理过程中的新型细胞类型或细胞状态转变,探索潜在的治疗靶点。
- <strong>感染性疾病免疫应答研究</strong>:分析病毒或细菌感染后宿主免疫细胞的动态变化,识别关键的抗病毒/抗细菌免疫细胞亚群和分子机制。
相关科研场景
查看全部场景核心功能
使用场景
优点与局限
优点
- +<strong>卓越的性能与可扩展性</strong>:能够高效处理大规模单细胞数据集,满足高通量测序数据分析需求,尤其适合处理百万级细胞数据。
- +<strong>高度的灵活性与定制化</strong>:基于Python编程,允许用户自由组合分析模块,实现个性化分析流程和算法开发,便于整合自定义功能。
- +<strong>丰富的分析功能</strong>:提供从基础预处理到高级轨迹推断、细胞间通讯等全面的分析工具,满足多样化的科研需求。
- +<strong>活跃的社区支持与详尽文档</strong>:拥有庞大的用户群体和完善的官方文档、教程,便于学习和解决分析过程中遇到的问题。
局限
- -<strong>对Python编程能力有要求</strong>:对于不熟悉Python的用户,学习曲线相对陡峭,需要投入时间掌握编程基础和数据结构。
- -<strong>缺乏图形用户界面(GUI)</strong>:主要通过命令行或Jupyter Notebook操作,对于偏好可视化、点击式操作的用户可能不够友好。
- -<strong>依赖外部环境配置</strong>:安装和管理Python环境及依赖库(如conda)可能对初学者构成挑战,需要一定的系统管理知识。
快速上手
安装Scanpy:确保已安装Python和conda环境。在终端运行 <code>conda install -c conda-forge scanpy</code> 或 <code>pip install scanpy</code>。
加载数据:准备好HDF5 (.h5ad) 或 CSV/TSV 格式的单细胞表达矩阵和细胞/基因元数据,使用 <code>anndata.read_h5ad()</code> 或 <code>scanpy.read_csv()</code> 导入。
运行基本分析:按照官方教程,依次执行 <code>sc.pp.normalize_total()</code>, <code>sc.pp.log1p()</code>, <code>sc.pp.highly_variable_genes()</code>, <code>sc.tl.pca()</code>, <code>sc.pp.neighbors()</code>, <code>sc.tl.umap()</code>, <code>sc.tl.leiden()</code> 等核心函数。
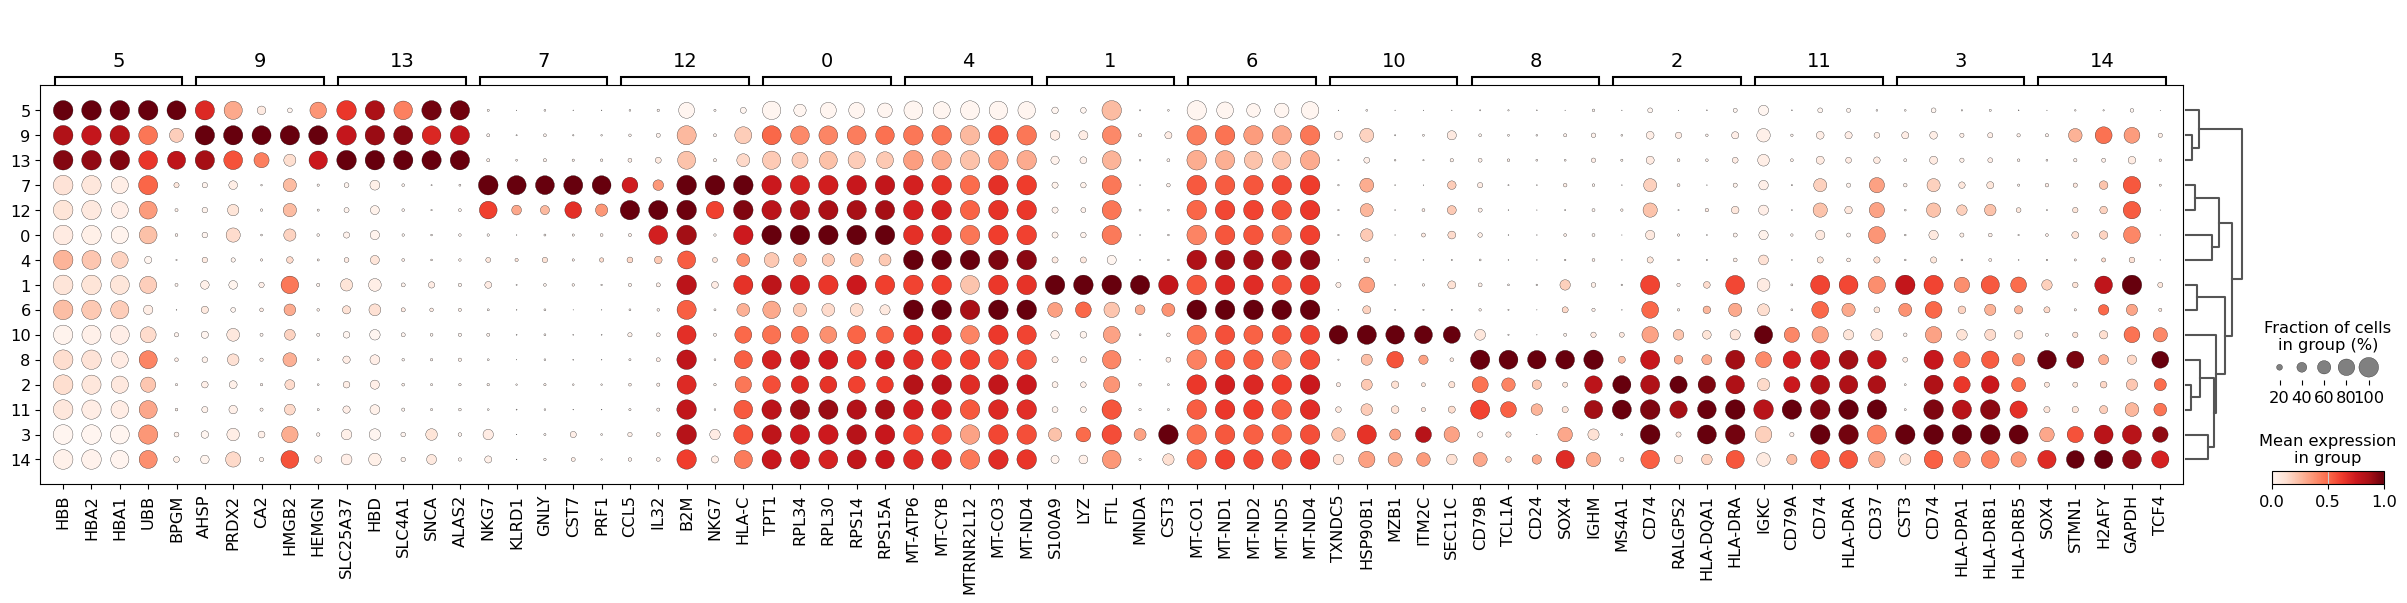
可视化结果:使用 <code>sc.pl.umap()</code> 或 <code>sc.pl.dotplot()</code> 等函数,快速生成降维聚类图和marker基因表达图,初步探索数据。
详细介绍
这个工具解决什么问题
单细胞RNA测序(scRNA-seq)技术已成为解析复杂生物系统细胞异质性的强大手段,广泛应用于肿瘤、免疫、神经科学等医学研究领域。然而,scRNA-seq数据具有高维度、稀疏性、噪声大等特点,其分析过程对计算资源和专业知识提出了较高要求。传统的数据处理方法往往难以高效应对百万级甚至千万级细胞的数据量,且缺乏统一、灵活的分析框架。
Scanpy正是为解决这些挑战而设计的。它提供了一个高效、可扩展且功能全面的Python库,用于单细胞基因表达数据的预处理、降维、聚类、差异表达分析、细胞轨迹推断以及高级可视化。通过Scanpy,研究人员能够系统地探索细胞类型组成、识别疾病特异性细胞状态、揭示细胞间相互作用,从而深入理解疾病发生发展机制,并为精准医疗提供潜在靶点。
Scanpy的核心功能与优势
Scanpy构建在Python强大的科学计算生态系统之上,与NumPy、SciPy、Pandas等库无缝集成,为用户提供了极大的灵活性和扩展性。其核心优势在于能够处理大规模单细胞数据集,并提供一套完整的分析工作流。
- 高性能数据处理:Scanpy采用优化的数据结构(
anndata对象)和算法,能够高效地存储和操作大规模单细胞数据,显著缩短分析时间,即使面对百万级细胞数据也能保持流畅。 - 全面的分析模块:涵盖从原始数据导入、质量控制、归一化、特征选择、降维(如PCA、UMAP、t-SNE)、聚类(如Leiden、Louvain)、差异基因表达分析,到细胞轨迹推断(如PAGA、Diffusion Maps)等一系列标准及高级分析步骤。
- 高级可视化能力:集成了Matplotlib和Seaborn等Python绘图库,提供丰富的可视化选项,包括UMAP/t-SNE降维图、热图、小提琴图、点图、轨迹图等,帮助用户直观理解数据结构和生物学发现。
- 灵活的编程接口:作为Python库,Scanpy允许用户通过编写脚本进行高度定制化的分析,方便整合其他Python工具,并支持自动化工作流的构建和批处理。
- 活跃的社区支持与文档:拥有庞大的用户社区和详尽的官方文档,为用户提供了丰富的学习资源、教程和问题解决方案,降低了学习门槛。
Scanpy的模块化设计使得用户可以根据具体研究问题,自由组合和调整分析流程中的各个环节,实现高度定制化的数据探索。这种灵活性对于应对复杂多变的医学科研问题至关重要。
医学科研中的应用场景
Scanpy在医学科研中具有广泛的应用潜力,能够帮助研究人员从单细胞层面揭示疾病的分子机制和细胞病理学特征。
例如,在肿瘤免疫微环境研究中,研究人员可以利用Scanpy对肿瘤组织中的免疫细胞进行分型,识别浸润性T细胞、巨噬细胞等亚群,并分析其在肿瘤进展中的动态变化和功能状态。通过差异基因表达分析,可以发现与肿瘤预后或治疗反应相关的细胞特异性生物标志物。
在神经退行性疾病研究中,Scanpy可用于分析患者脑组织或类器官模型中的神经元、胶质细胞等细胞类型的基因表达谱,识别疾病早期或晚期特有的细胞状态和分子通路。这有助于理解疾病的起始机制,并为开发新的治疗策略提供线索。
此外,Scanpy也被广泛应用于药物作用机制的探索。通过对药物处理前后细胞的单细胞转录组数据进行比较分析,研究人员可以精确识别药物作用的靶细胞类型、激活或抑制的信号通路,以及可能产生的脱靶效应,从而优化药物设计和评估其潜在毒性。
Scanpy的轨迹推断功能,例如PAGA,可以帮助研究人员在发育生物学或疾病进展中,重建细胞分化或状态转变的路径,从而理解细胞命运决定的分子事件。这对于研究干细胞分化、组织再生或疾病的慢性演变过程具有重要意义。
如何开始使用Scanpy
Scanpy的学习曲线对于有Python基础的用户而言相对平缓,而对于R语言背景的用户可能需要适应Python的编程范式。其核心工作流通常包括以下几个阶段:
首先,数据导入与预处理是基础。这包括读取原始的表达矩阵(通常是计数矩阵),进行质量控制(过滤低质量细胞和基因)、归一化(消除测序深度差异)和对数转换,以准备高质量的数据用于后续分析。Scanpy提供了scanpy.read_10x_mtx()等函数方便导入数据。
其次,进行特征选择与降维。通过识别高变基因,可以聚焦于最具生物学意义的基因。随后,利用主成分分析(PCA)降低数据维度,并进一步使用UMAP或t-SNE等非线性降维算法,将细胞投影到二维或三维空间,以便可视化细胞群体的结构。
接着是细胞聚类与注释。在降维后的空间中,Scanpy支持多种聚类算法(如Leiden或Louvain),将相似的细胞聚集成群。通过对每个细胞簇进行差异基因表达分析,并结合已知的细胞标志物,可以对这些细胞簇进行生物学注释,识别出不同的细胞类型或状态。
最后,结果可视化与深入分析。Scanpy提供了丰富的绘图功能,如UMAP图、小提琴图、点图等,用于展示细胞聚类、基因表达模式和差异基因。此外,还可以进行细胞轨迹推断、细胞间通讯分析等高级分析,以揭示更深层次的生物学机制。
适用与不适用情况
Scanpy作为一款强大的单细胞数据分析工具,并非适用于所有情况。了解其最佳应用场景和局限性,有助于研究者做出明智的选择。
Scanpy特别适合以下医学科研场景:
- 处理大规模单细胞RNA测序数据集(例如,数万到数百万个细胞),需要高效的计算性能和内存管理。
- 研究者已经具备Python编程基础,或愿意投入时间学习Python,以实现高度定制化的分析流程和与其他Python库的集成。
- 需要进行复杂的高级分析,如细胞轨迹推断、细胞间通讯分析、批次效应校正等,并希望灵活地调整算法参数。
- 追求高质量、可定制化的数据可视化,以清晰地呈现研究发现。
- 希望利用活跃的开源社区资源,获取最新的算法更新和技术支持。
然而,在以下情况下,Scanpy可能不是最佳选择:
- 研究者完全没有编程经验,且不打算学习Python,更倾向于图形用户界面(GUI)或R语言环境。
- 处理的单细胞数据集规模非常小(例如,数百个细胞),且仅需进行基础的统计分析,此时R语言的Seurat或其他更轻量级的工具可能更为便捷。
- 主要需求是上游数据处理(如原始测序数据比对、计数矩阵生成),Scanpy主要侧重于下游分析,上游工作通常需要Cell Ranger等工具配合。
- 对即时可视化反馈有较高要求,而对编程控制的灵活性需求较低。
总而言之,Scanpy是单细胞数据分析领域的一个重要工具,尤其适合那些寻求高性能、高灵活性和深度定制化分析的医学科研人员。对于希望深入挖掘单细胞数据背后生物学意义的研究者来说,掌握Scanpy将是一个宝贵的技能。
替代选择
如果 Scanpy 不适合你,可以考虑:
同类工具推荐
如果你需要更完整的文献工作流
从检索到精读,一站完成
这个工具适合特定场景。如果你需要中文检索、实时翻译、AI 辅助精读,可以试试超能文献。
了解超能文献